%20--%3e%3csvg%20version='1.1'%20id='Layer_1'%20xmlns='http://www.w3.org/2000/svg'%20xmlns:xlink='http://www.w3.org/1999/xlink'%20x='0px'%20y='0px'%20viewBox='0%200%20120.17%2045.43'%20style='enable-background:new%200%200%20120.17%2045.43;'%20xml:space='preserve'%3e%3cg%3e%3cpath%20d='M32.33,0v16.13c0,2.21-0.42,4.3-1.26,6.26c-0.84,1.97-2,3.7-3.49,5.18c-1.49,1.49-3.2,2.65-5.15,3.49%20c-1.94,0.84-4.04,1.26-6.3,1.26c-2.21,0-4.3-0.42-6.26-1.26c-1.97-0.84-3.68-2-5.15-3.49c-1.46-1.49-2.62-3.21-3.46-5.18%20C0.42,20.42,0,18.34,0,16.13V0h6.41v16.13c0,1.34,0.25,2.62,0.76,3.82c0.5,1.2,1.2,2.24,2.09,3.13c0.89,0.89,1.92,1.58,3.1,2.09%20c1.18,0.5,2.44,0.76,3.78,0.76c1.34,0,2.62-0.25,3.82-0.76c1.2-0.5,2.24-1.2,3.13-2.09c0.89-0.89,1.58-1.93,2.09-3.13%20c0.5-1.2,0.76-2.47,0.76-3.82V0H32.33z'%20fill='%232563eb'%20/%3e%3cpath%20d='M50.4,0.14c2.26,0,4.36,0.42,6.3,1.26c1.94,0.84,3.66,1.99,5.15,3.46c1.49,1.46,2.65,3.17,3.49,5.11%20c0.84,1.94,1.26,4.04,1.26,6.3c0,2.21-0.42,4.3-1.26,6.26c-0.84,1.97-2,3.7-3.49,5.18c-1.49,1.49-3.2,2.65-5.15,3.49%20c-1.94,0.84-4.04,1.26-6.3,1.26h-9.72v12.96h-6.41V16.27c0-2.26,0.42-4.36,1.26-6.3c0.84-1.94,1.99-3.65,3.46-5.11%20c1.46-1.46,3.18-2.62,5.15-3.46C46.1,0.56,48.19,0.14,50.4,0.14z%20M54.22,25.31c1.2-0.5,2.24-1.2,3.13-2.09%20c0.89-0.89,1.58-1.93,2.09-3.13c0.5-1.2,0.76-2.47,0.76-3.82c0-1.34-0.25-2.6-0.76-3.78c-0.5-1.18-1.2-2.21-2.09-3.1%20c-0.89-0.89-1.93-1.58-3.13-2.09c-1.2-0.5-2.47-0.76-3.82-0.76c-1.34,0-2.6,0.25-3.78,0.76c-1.18,0.5-2.21,1.2-3.1,2.09%20c-0.89,0.89-1.58,1.92-2.09,3.1c-0.5,1.18-0.76,2.44-0.76,3.78v9.79h9.72C51.74,26.06,53.02,25.81,54.22,25.31z'%20fill='%232563eb'/%3e%3cpath%20d='M94.03,20.95l4.54,4.54l-2.23,2.23c-1.54,1.54-3.29,2.71-5.26,3.53c-1.97,0.82-4.03,1.22-6.19,1.22%20c-2.16,0-4.22-0.41-6.19-1.22c-1.97-0.82-3.72-1.99-5.26-3.53c-1.58-1.58-2.76-3.37-3.53-5.36c-0.77-1.99-1.15-4.02-1.15-6.08%20c0-2.06,0.38-4.08,1.15-6.05c0.77-1.97,1.94-3.74,3.53-5.33s3.37-2.77,5.36-3.56c1.99-0.79,4.02-1.19,6.08-1.19%20c2.06,0,4.09,0.4,6.08,1.19c1.99,0.79,3.78,1.98,5.36,3.56l2.23,2.23L80.64,25.06c1.82,0.91,3.75,1.21,5.8,0.9%20c2.04-0.31,3.83-1.24,5.36-2.77L94.03,20.95z%20M77.98,9.36c-1.92,1.92-2.88,4.22-2.88,6.91c0,1.49,0.33,2.9,1.01,4.25%20c0.58-0.58,1.45-1.45,2.63-2.63c1.18-1.18,2.42-2.42,3.74-3.74c1.32-1.32,2.59-2.58,3.82-3.78c1.22-1.2,2.17-2.14,2.84-2.81%20c-1.83-0.91-3.76-1.22-5.8-0.94C81.3,6.91,79.51,7.82,77.98,9.36z'%20fill='%232563eb'%20/%3e%3cpath%20d='M120.17,0v6.41h-3.24c-1.35,0-2.61,0.25-3.78,0.76c-1.18,0.5-2.21,1.2-3.1,2.09c-0.89,0.89-1.58,1.92-2.09,3.1%20c-0.5,1.18-0.76,2.44-0.76,3.78v16.2h-6.48v-16.2c0-2.26,0.42-4.36,1.26-6.3c0.84-1.94,2-3.65,3.49-5.11%20c1.49-1.46,3.21-2.62,5.18-3.46c1.97-0.84,4.06-1.26,6.27-1.26H120.17z'%20fill='%232563eb'/%3e%3c/g%3e%3c/svg%3e)
30 października 2026 roku John Mueller ogłosił na blogu Google Search Central, że Google będzie obsługiwać wspólną kontrolę treningu AI w robots.txt. Zamiast dopisywać osobną regułę dla każdego bota, wydawca ustawi jedną preferencję, którą odczyta wielu dostawców AI naraz. Google planuje wdrożyć ten mechanizm w 2027 roku razem z innymi dostawcami AI. Na razie to zapowiedź, a nie gotowy standard, który właściciele stron mogą już stosować.
Co dokładnie ogłosił Google
Pomysł wyrasta z prac grupy roboczej AIPREF w IETF (Internet Engineering Task Force), organizacji standaryzującej protokoły internetowe. Wydawca wpisze do robots.txt wspólny token określający preferencje (w zapowiedzi policy token) i w ten sposób wyrazi swoje stanowisko wobec wszystkich dostawców AI, którzy przystąpią do porozumienia.
Najwięcej zmienia reguła interpretacji. Jeśli strona zrezygnuje z treningu nowym tokenem, a w pliku nie ma wprost wymienionego Google-Extended, Google potraktuje to tak, jakby wydawca zablokował Google-Extended. Inni dostawcy mogą przyjąć tę samą zasadę, więc da się wyrazić sprzeciw wobec trenowania modeli u wszystkich uczestniczących dostawców naraz albo decydować o każdym z osobna.
Firmowe kontrole zostają i działają równolegle z nowym sygnałem. Ogólną preferencję ustawisz więc wspólnym tokenem, a dla Google doprecyzujesz ją przez Google-Extended. Google zaznacza też, że witryny, które wprost zezwalają Google-Extended, mogą pojawiać się w odpowiedziach aplikacji Gemini i dostawać z nich kliknięcia dzięki groundingowi, czyli podawaniu modelowi treści z indeksu w chwili zapytania.
Jak to wygląda w praktyce: token, nie dyrektywa
We wpisie na blogu nie ma składni. Podaje ją dopiero dokumentacja wspólnych crawlerów Google: przy opisie Google-Extended stoi, że Google zamierza obsłużyć wspólny, czytelny maszynowo sygnał preferencji treningu AIPREF „na początku 2027 roku”, zapisywany jako user-agent: __usage_ai-training.
Szkic IETF proponuje co innego. Aktualna wersja dokumentu o dołączaniu preferencji (draft-ietf-aipref-attach-05, sierpień 2026) opisuje dyrektywę Content-Usage, na przykład:
User-Agent: *
Allow: /
Content-Usage: train-ai=n
Content-Usage: /ai-ok/ train-ai=y
Taki zapis zabrania treningu w całym serwisie poza katalogiem /ai-ok/. To przykład składni ze szkicu IETF, a nie składnia zapowiedziana przez Google, więc nie traktuj go jako instrukcji wdrożenia. Google w zapowiedzi i dokumentacji mówi jednak o tokenie w linii user-agent, a nie o Content-Usage, i nie tłumaczy, skąd ta różnica ani czy ostateczny standard połączy oba podejścia. Póki trwają prace nad szkicem, żadnej z tych składni nie warto wdrażać na produkcji.
Czym jest „trening AI” w propozycji IETF
Drugi dokument grupy, szkic słownika preferencji dotyczących użycia treści przez AI (draft-ietf-aipref-vocab-08, wrzesień 2026), wyróżnia kilka kategorii użycia treści:
| Kategoria | Klucz | Znaczenie według szkicu |
|---|---|---|
| Trening AI | train-ai | Użycie treści do zmiany parametrów generatywnego modelu AI |
| Użycie AI | ai-use | Użycie treści jako wejścia do generatywnego modelu, gdy nie dostarcza jej bezpośrednio użytkownik |
| Wyszukiwanie | search | Użycie w aplikacji, której głównym celem jest wskazanie użytkownikom lokalizacji treści |
Google wykorzysta na razie tylko definicję kategorii treningu AI, a o reszcie słownika rozmowy mają toczyć się dalej. Sam szkic ostrzega, że nie odzwierciedla konsensusu grupy roboczej i służy jako podstawa do dyskusji, więc nazwy i definicje mogą się jeszcze zmienić.
Co to zmienia dla właściciela strony
Na dziś niewiele, choć widać, w którą stronę to zmierza.
- Mniej reguł do pilnowania. Dziś w robots.txt trzyma się listę botów AI i trzeba ją co jakiś czas uzupełniać, o czym pisałem przy crawlerach AI i wyszukiwarkowych. Wspólny sygnał skróci tę listę, ale jej nie zlikwiduje, bo nie każdy dostawca go obsłuży.
- Firmowe tokeny zostają. Jeśli chcesz potraktować Google inaczej niż resztę, nadal służy do tego
Google-Extended. Jego zakres opisałem w artykule o tym, co działa w robots.txt Google. - Trening i wyszukiwarka to osobne sprawy. Według dokumentacji
Google-Extendednie wpływa na obecność w wynikach wyszukiwania ani na pozycje. Widoczność w AI Overviews i AI Mode to jeszcze inne ustawienie, opisane niżej. - Zmiana nie działa wstecz. Według szkicu IETF crawler stosuje preferencje z tej wersji robots.txt, którą znał w chwili pobierania zasobu. Nowe reguły nie obejmują więc automatycznie treści zebranych wcześniej, a zaczynają działać dopiero wtedy, gdy crawler pobierze zaktualizowany plik, a potem jeszcze raz dany zasób.
Ten mechanizm ma też wyraźną granicę. Szkic słownika przyznaje wprost, że preferencje nie gwarantują, że ktoś ich przestrzega, i nie rozstrzygają, czy powinien. Taki wpis działa jak prośba, której nikt nie musi spełnić, dlatego rzeczywistą blokadę nadal trzeba egzekwować na serwerze albo w CDN-ie.
Trening, grounding i AI Overviews: co kontroluje które ustawienie
Łatwo to pomylić, bo Google ma dziś kilka przełączników, a każdy dotyczy czegoś innego.
| Ustawienie | Co kontroluje | Czego nie kontroluje |
|---|---|---|
Google-Extended w robots.txt | Trening przyszłych modeli Gemini oraz grounding w aplikacjach Gemini i w Grounding with Google Search na Vertex AI | Obecności i pozycji w wyszukiwarce |
| Search generative AI w Search Console (Ustawienia) | Widoczność w AI Overviews, AI Mode i generatywnych funkcjach Discover, także jako źródło groundingu tych funkcji | Treningu modeli i zwykłych wyników wyszukiwania |
| Wspólny token AIPREF w robots.txt (od 2027 roku) | Preferencję treningu u dostawców, którzy go obsłużą; w Google działa jak blokada Google-Extended, jeśli ten nie jest wymieniony w pliku | Na razie niczego, bo jeszcze nie działa |
noindex w meta tagu lub nagłówku HTTP | Obecność strony w wyszukiwarce w ogóle | Treningu modeli |
Google-Extended nie jest więc wyłącznie przełącznikiem treningu. Jego zablokowanie odcina też wykorzystanie treści przy odpowiedziach na bieżące zapytania w Gemini. Nie wpływa natomiast na AI Overviews i AI Mode, bo o nich decyduje ustawienie w Search Console, od 31 sierpnia 2026 dostępne dla wszystkich witryn. Jak działa i co wyłącza, opisałem przy kartach cytowań w AI Overviews. Według pomocy Search Console wykluczenie witryny z tych funkcji nie zmienia jej obecności w zwykłych wynikach.
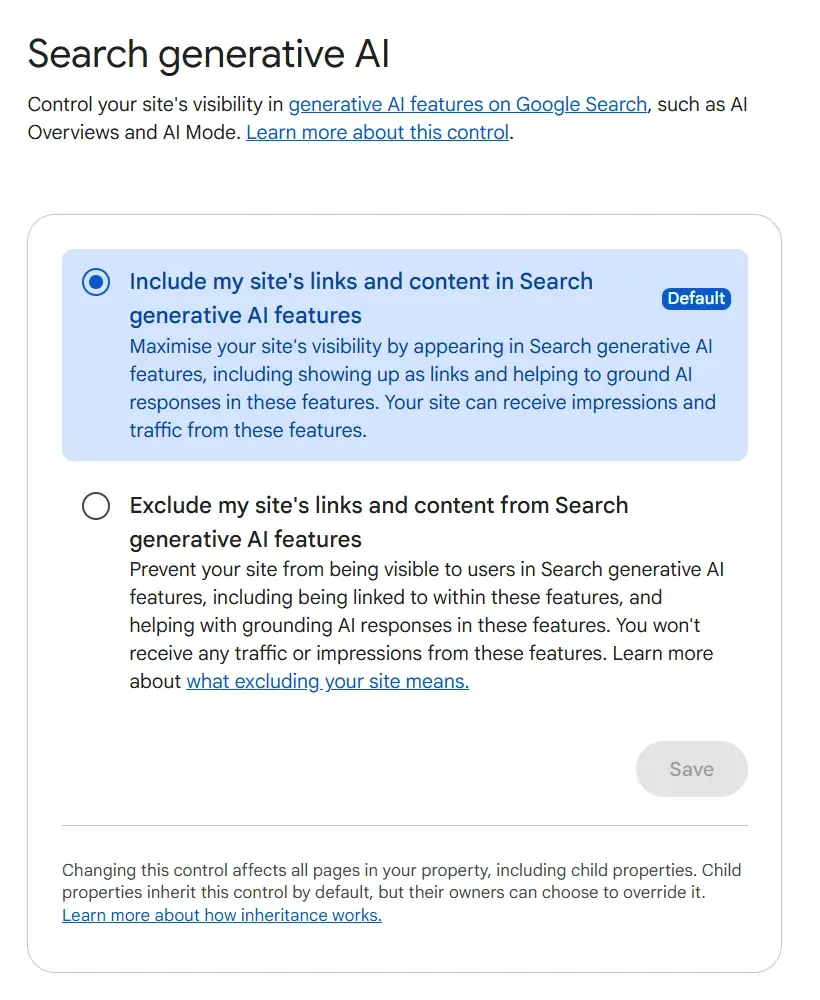
Ustawienie znajdziesz w Search Console w Ustawieniach, w grupie AI controls (zrzut pochodzi z angielskiego interfejsu). Widać je tu dla uper.pl, w domyślnym stanie.
Ryzyko po stronie biznesu
Wypisanie się z treningu ma koszt, o którym wydawcy rzadko myślą. Google łączy możliwość pojawiania się w odpowiedziach Gemini i zbierania z nich kliknięć z wyraźną zgodą na Google-Extended, a ten sam token obejmuje grounding. Skoro sprzeciw wyrażony wspólnym tokenem Google ma traktować jak blokadę Google-Extended, kto jednym wpisem zablokuje wszystko, prawdopodobnie zamknie sobie przy okazji tę drogę do widoczności. W zapowiedzi Google nie napisał tego wprost, dlatego tę kwestię lepiej przemyśleć przed zmianą w pliku niż po niej.
Google powołuje się też na kontekst regulacyjny. Propozycja jest zgodna z unijnym Kodeksem Postępowania dla dostawców modeli AI ogólnego przeznaczenia (GPAI) w ramach AI Act, który uznaje robots.txt za podstawowy sposób wyrażania preferencji przez wydawców. To może przyspieszyć przyjęcie standardu, choć z samej zapowiedzi nie wynika, kto do niego dołączy.
Co robić teraz
- Ustal swoją politykę. Zdecyduj, czy blokujesz trening całkowicie, dopuszczasz go częściowo, czy niczego nie zmieniasz. Bez tej decyzji składnia niczego nie załatwi.
- Przejrzyj obecny robots.txt. Sprawdź, jakie tokeny AI już tam są i czy reguły sobie nie przeczą. Podstawy składni znajdziesz w przewodniku po robots.txt.
- Wstrzymaj się z
__usage_ai-training. Google zapowiada obsługę dopiero w 2027 roku, a szkic IETF wciąż się zmienia. - Śledź zapowiedzi innych dostawców. Wspólny sygnał jest tyle wart, ilu dostawców go obsłuży.
Podsumowanie
Google chce, żeby jedna preferencja w robots.txt zastąpiła kilka osobnych reguł dla botów trenujących modele AI. Pomysł opiera się na pracach IETF, a wdrożenie razem z innymi dostawcami ma nastąpić w 2027 roku. Google-Extended zostaje i będzie działał obok wspólnego sygnału. Nie ma jeszcze ostatecznej składni ani listy firm, które ją obsłużą, a sam standard pozostaje szkicem bez pełnego konsensusu. To dobry moment, żeby ustalić własną politykę wobec AI, ale za wcześnie na zmiany w plikach.
Często zadawane pytania
Czy wspólna kontrola treningu AI już działa?
Nie. Google ogłosił 30 października 2026 roku, że zamierza ją obsługiwać, i celuje w 2027 rok, razem z innymi dostawcami AI. Na razie działają tylko firmowe tokeny, takie jak Google-Extended.
Czy nowy sygnał zastąpi Google-Extended?
Nie, będzie działał obok niego. Liczy się to, czy robots.txt zawiera osobną regułę dla Google-Extended. Jeśli zrezygnujesz z treningu wspólnym tokenem, a takiej reguły nie ma, Google potraktuje to jak zablokowanie Google-Extended. Jeśli jest, możesz nią ustawić Google inaczej niż pozostałych dostawców.
Czy zakaz treningu AI wpłynie na pozycje w Google?
Według dokumentacji Google-Extended nie wpływa na obecność w wyszukiwarce ani na pozycje. Widoczność w AI Overviews i AI Mode reguluje osobne ustawienie Search generative AI w Search Console. Google wiąże jednak zgodę na Google-Extended z możliwością pojawiania się w odpowiedziach Gemini przez grounding, więc zakaz może tę drogę zamknąć.
Czy dostawcy AI muszą przestrzegać takiego sygnału?
Sam standard tego nie wymusza, a szkic IETF zaznacza, że preferencje nie gwarantują przestrzegania. Unijny Kodeks Postępowania GPAI może zwiększyć presję na dostawców, ale technicznie to dobrowolny sygnał, a nie blokada.
Źródła
- Google Search Central Blog: Supporting a shared AI training control for websites https://developers.google.com/search/blog/2026/10/ai-training-control
- Google Search Central: Google common crawlers (Google-Extended) https://developers.google.com/crawling/docs/crawlers-fetchers/google-common-crawlers
- Google Search Console Help: Search generative AI control https://support.google.com/webmasters/answer/16908024
- IETF: AI Preference Attachment (draft-ietf-aipref-attach-05) https://www.ietf.org/archive/id/draft-ietf-aipref-attach-05.html
- IETF: A Vocabulary For Expressing AI Usage Preferences (draft-ietf-aipref-vocab-08) https://datatracker.ietf.org/doc/draft-ietf-aipref-vocab/

'%3E%3Cpath d='M0 0v30h60V0z' fill='%23012169'/%3E%3Cpath d='M0 0l60 30m0-30L0 30' stroke='%23fff' stroke-width='6'/%3E%3Cpath d='M0 0l60 30m0-30L0 30' clip-path='url(%23b)' stroke='%23C8102E' stroke-width='4'/%3E%3Cpath d='M30 0v30M0 15h60' stroke='%23fff' stroke-width='10'/%3E%3Cpath d='M30 0v30M0 15h60' stroke='%23C8102E' stroke-width='6'/%3E%3C/g%3E%3C/svg%3E)